8526 个带价格的 PR:代码量对不上钱
我拿 Expensify 真实付过钱的 8526 个代码改动,检验了数 PR、数代码行、看留存这几种算法:它们和付的钱几乎无关,留存也猜不出以后的 bug。
上一篇《只看得见分母》的结尾,我提了一把尺子:合并后 N 个月内没被回滚、没被大改的代码,才算一份产出。然后说,它能不能代表真实价值,得先检验。
我自己差点跳过这一步。我已经用这把尺子比过 20 个开源仓库里 Opus 和 Sonnet 写的代码哪个留得久,正准备扩大到 300 个仓库。扩大之前,我先拿一份带真实价格的公开数据,检验了它和另外几种常见的数法。
结果是:数 PR、数代码行、看代码留了多久,都和真实付的钱几乎无关;“留得久”也猜不出以后会不会出 bug。
一份每个改动都标了价的数据
卖“每个合并 PR 花多少钱”的公司,分子大多从 PR 出发:Jellyfish 数合并的 PR,Larridin 在这个基础上按复杂度和质量加权。[1][2] 要检验这类分子,得有一个独立的、用钱表示的判断。这样的公开数据很少。
Expensify 的报销 App 是开源的。很多活外包给外部开发者,按 issue 付钱,价格写在 issue 的标题上,代码上线 7 天后才付款。[3] OpenAI 的 SWE-Lancer 就是用这份数据给模型打分的。[4] 修 bug 时,Expensify 的流程还要求填一张检查单,写出是哪个 PR 引入了这个 bug。
我取了 2021 年 11 月到 2026 年 6 月合并的 8526 个 PR,每个都正好修好一个有价格的 issue。对每个 PR 算几种分子:新增代码行、改动文件数、合并 90 天后还留着的代码行数,以及留下来的比例。
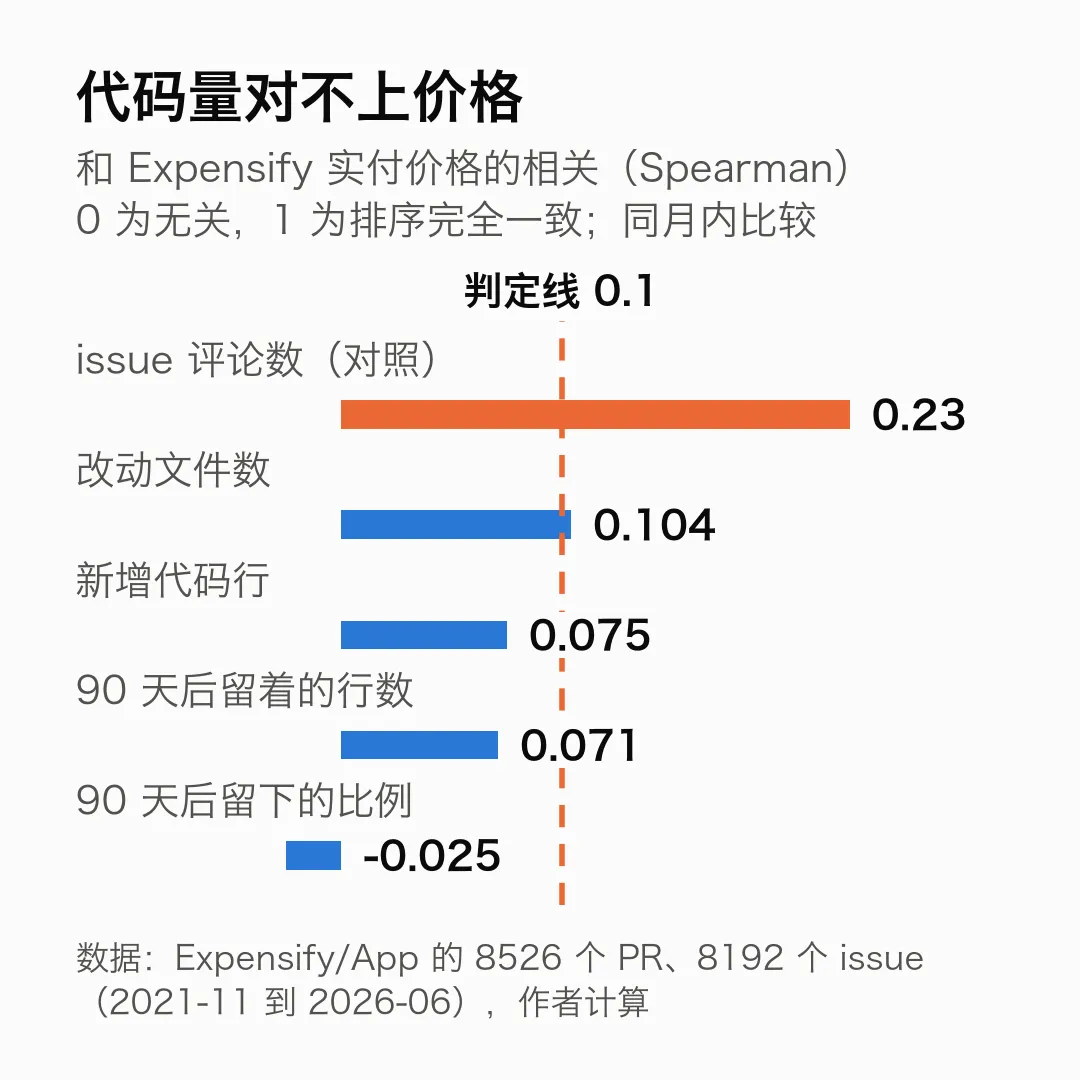
跑之前,我先定了判定线:和价格的相关低于 0.1,就算基本无关;到 0.3 才算支持。
代码多少,和付多少钱无关
我用的是 Spearman 相关系数,看两样东西的排序是否一致:0 是无关,1 是完全一致。Expensify 的价格按时期定,每个月 75% 到 90% 的 PR 都是当月的默认价,所以我在同一个月里比,再合起来。
新增代码行 0.075,90 天后留着的行数 0.071,留下来的比例 −0.025。只有改动文件数刚过线,0.104。
数 PR 更粗。价格的第 90 百分位是第 10 百分位的 4 倍,PR 数都记成 1。
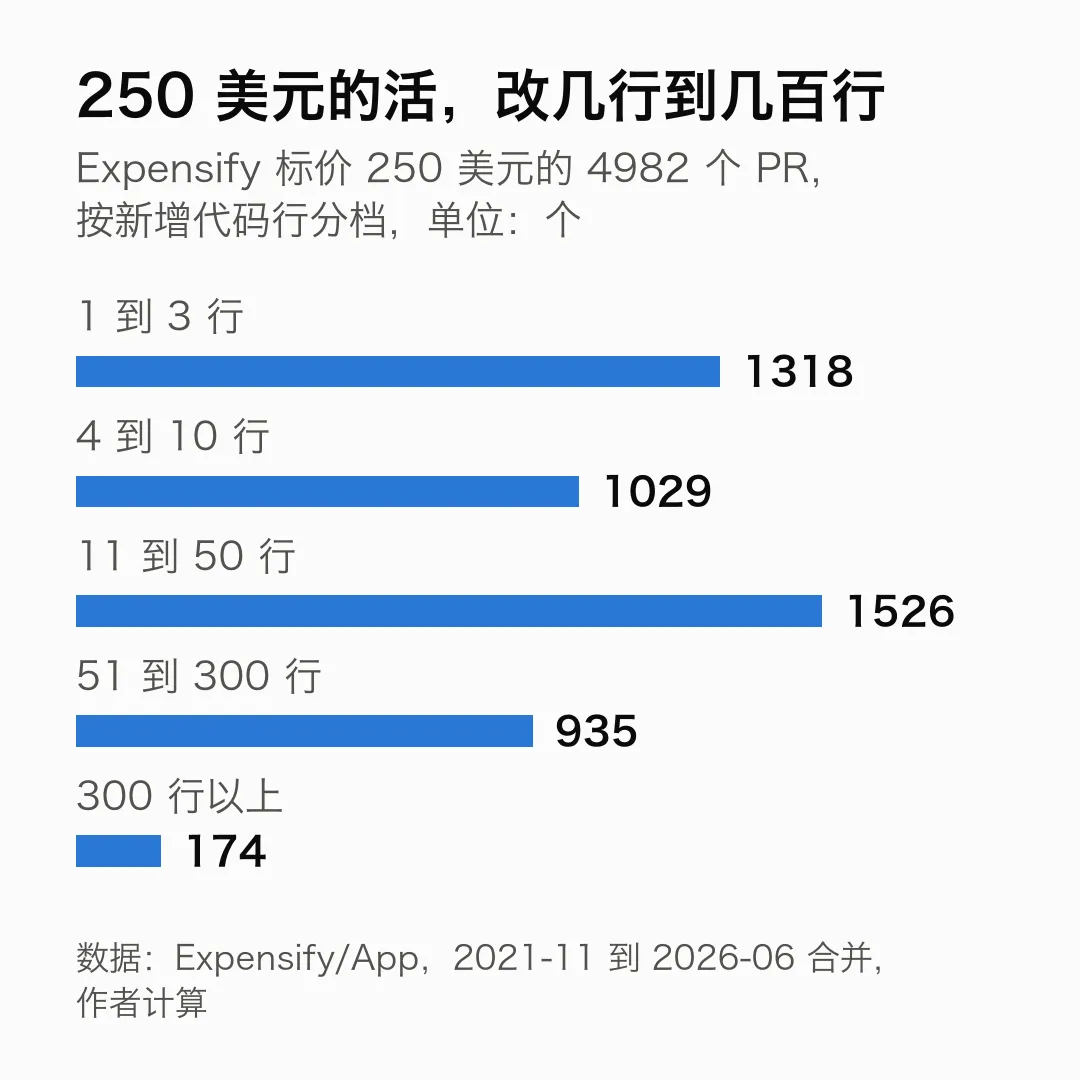
反过来看同一个价格。标价 250 美元的 4982 个 PR 里,四分之一只新增了 3 行以内的代码,中位数是 12 行,另有 174 个超过 300 行。
留得久,猜不出以后的 bug
留存背后的想法是:好代码留得久,烂代码很快被改掉。Expensify 的检查单正好能检验这一点。
2025 年 1 月到 2026 年 3 月合并的 2982 个 PR 里,有 55 个在合并 90 天以后才被点名引入了 bug。我只看 90 天以后才报的:修 bug 本身会改掉原来的代码,90 天内报的 bug 会直接把留存拉低,等于拿结果检验结果。
拿 90 天留存去区分这 55 个 PR 和其余的 PR,按代码量分成四档,AUC 在 0.40 到 0.54 之间。AUC 是 0.5 就等于抛硬币。四档里有三档低于 0.5,也就是后来被点名的 PR,留存反而略高。区间都包含 0.5,说不了方向,只能说猜不出。
一个可能的原因是,没人用的代码也没人碰。据一项 2012 年的研究,在一家再保险公司的业务系统里,生产环境执行过的方法有 40.7% 后来被修改过,从没执行过的只有 8.3%。[5] 按留存看,死代码留得最久。
信息在问题里,不在代码里
也许价格本身就是噪声,和什么都对不上。为了排除这一点,我又看了 issue 一侧的 12 个信号。
最强的是 issue 的评论数,0.23;问题描述的长度 0.16;有几个人提了方案 0.13。都比代码一侧强。评论数里有一部分是机器人的催办和涨价通知,挂得越久越多;只看从没涨过价的 issue,它降到 0.14,描述长度和方案数基本不变。
所以价格里有能读出来的信息,只是不在代码里。能读出来的也不多:12 个信号放在一起,用前一段时间的数据拟合,在之后的 6614 个 issue 上检验,相关只有 0.165。
这份数据说明不了什么
价格不是价值。它反映的是 Expensify 觉得这个问题多急、多难、多久没人做,不是修好以后给业务带来多少钱。
只有一家公司、一个前端项目。2025 年以后价格几乎是一口价,近九成是 250 美元。我按月比,用的其实是偏离默认价的那部分;价格还分档的 2022 到 2024 年,代码行的相关是 0.032,结论一样。
我只测了最粗的几种分子。Larridin 那种按复杂度和质量加权的分子没测,它的打分模型不公开。
被点名的 bug 很稀疏。没被点名,不等于没有 bug。
所以结论只能写到这一步:这几种分子没过第一道检验。不能说它们一定没用,更不能说所有分子都不行。那 20 个仓库的 Opus 和 Sonnet 对比,我暂时不扩大了:尺子量的是什么还不清楚,量出来的差别也说明不了哪个模型更值。
如果你在用“每个合并 PR 花多少钱”的看板,可以做同样的检查:拿手里任何一个独立的判断,比如任务的工时估算、优先级,或者事后复盘里被点名的 PR,对一下看板上的分子。
来源
- Jellyfish,Nicholas Arcolano,2026-04-15,Is “tokenmaxxing” cost effective? New data from Jellyfish explains。
- Larridin,AI coding 基准数据,截至 2026-08-02 的 4 周。
- Expensify/App 仓库,外部贡献者指南和悬赏 issue,2026-10-03 查阅。文中的相关系数和 AUC 是我用仓库的公开记录算的。
- OpenAI,Samuel Miserendino 等,2025-02-17,SWE-Lancer: Can Frontier LLMs Earn $1 Million from Real-World Freelance Software Engineering?,arXiv 2502.12115。
- Sebastian Eder、Maximilian Junker、Elmar Jürgens 等,ICSE 2012,How Much Does Unused Code Matter for Maintenance?。